


노트북에서 돌아가는 오픈소스 코딩 AI, Recursive Flint 써볼 만할까?
요즘 코딩할 때 Claude나 Codex 같은 클라우드 AI 없이는 일이 안 될 정도죠. 그런데 쓰다 보면 늘 걸리는 게 있습니다. 토큰 요금은 계속 올라가고, 회사 코드를 외부 서버로 보내도 되나 싶은 찜찜함도 있고요...
그런데 지난 10월 21일, 노트북에서 돌아가는 40B급 오픈소스 코딩 모델이 나왔다고 해서 자세히 알아봤습니다. 바로 Recursive Flint 입니다.
Recursive Flint란?
Flint는 미국의 AI 스타트업 Recursive가 내놓은 첫 번째 모델입니다. Recursive는 Salesforce 수석 과학자 출신인 리처드 소처(Richard Socher)가 이끄는 회사로, 올해 5월에 무려 6억 5천만 달러 투자를 받으며 등장했습니다. (GV, Nvidia, AMD Ventures 등이 투자했다고 하네요.)
재미있는 건 이 모델을 AI가 상당 부분 만들었다는 점입니다. 'Eureka Machine'이라는 자체 AI 연구 시스템이 아이디어를 내고, 실험을 돌리고, 결과를 보고 다음 실험을 정하는 방식으로 사전학습부터 후처리, 추론 최적화까지 거의 전 과정에 참여했다고 합니다. 덕분에 작은 팀이 4개월도 안 걸려서 모델을 처음부터 만들었다고 하니... 정말 대단하죠.
물론 사람이 감독하는 AI 연구 보조 수준이긴 하지만, "AI가 더 나은 AI를 만든다"는 개념을 실제 공개 모델로 보여준 초기 사례라는 점에서 주목받고 있습니다.
40B인데 어떻게 노트북에서 돌아갈까?
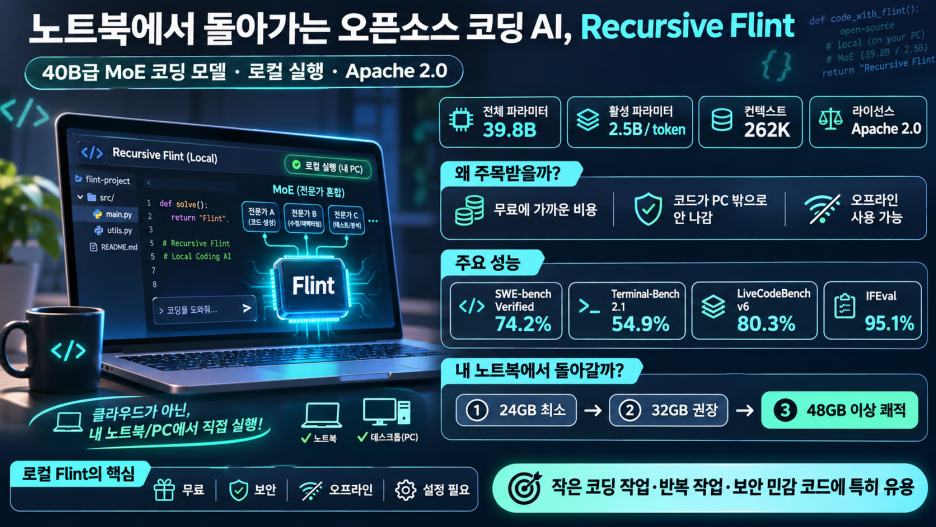
비밀은 MoE(Mixture of Experts, 전문가 혼합) 구조에 있습니다.
|
항목
|
수치
|
|
전체 파라미터
|
약 39.8B (40B)
|
|
토큰당 활성 파라미터
|
약 2.5B (전체의 약 6%)
|
|
컨텍스트 길이
|
최대 262,144 토큰
|
|
라이선스
|
Apache 2.0 (상업적 이용 가능)
|
|
배포처
|
Hugging Face RecursiveSI/flint
|
쉽게 비유하면 40명의 전문가가 대기하고 있는데, 질문 하나에 실제로 일하는 건 2~3명뿐인 구조입니다.
여기서 꼭 알아둘 점이 있습니다. 메모리는 '전체' 크기를 따라가고, 속도는 '활성' 크기를 따라갑니다. 즉, 40명 모두 사무실(메모리)에 앉아 있어야 하지만, 일은 소수만 하니까 빠른 거죠. 그래서 "2.5B면 가볍겠네?" 하고 8GB 노트북에서 돌리려고 하면 안 됩니다. ㅠㅠ
성능은 어느 정도일까?
Recursive가 발표한 주요 점수는 다음과 같습니다.
|
벤치마크
|
점수
|
의미
|
|
SWE-bench Verified
|
74.2%
|
실제 GitHub 버그 수정 능력
|
|
Terminal-Bench 2.1
|
54.9%
|
터미널 기반 에이전트 작업
|
|
LiveCodeBench v6
|
80.3%
|
코딩 문제 풀이
|
|
IFEval
|
95.1%
|
지시사항 준수
|
|
SWE-bench Pro v2
|
89.7%
|
※ 일반 SWE-bench Pro와 다른 버전
|
속도도 인상적입니다. M4 Pro 맥북 프로에서 초당 약 131 토큰을 생성해서, 같은 기기에서 Gemma 4나 Nemotron 3.5 Lightning 같은 비슷한 모델(초당 58~69 토큰)보다 약 2배 빨랐다고 합니다.
다만 숫자를 볼 때 주의할 점도 있습니다.
- 모두 Recursive 자체 측정 결과입니다. 독립 평가 사이트인 Artificial Analysis에는 아직 등록되지 않았습니다.
- 정확한 주장은 "50B 미만 MoE 모델 중 1위"라는 체급 기준입니다. 6개 테스트 평균으로는 Alibaba의 Qwen3.8 27B가 Flint보다 높았습니다.
- SWE-bench Pro v2는 다른 연구소들이 발표하는 SWE-bench Pro와 다른 벤치마크라서, 숫자를 직접 비교하면 안 됩니다.
- 속도 수치는 짧은 컨텍스트에서 Recursive 자체 추론 엔진(rec)으로 잰 값입니다.
내 노트북에서 돌아갈까? (메모리 요구사항)
가장 궁금한 부분이죠. 양자화 버전별로 정리해 봤습니다.
|
버전
|
파일 크기
|
권장 환경
|
|
Unsloth UD-Q3_K_XL (3bit)
|
약 18.5GB
|
RAM 24GB (짧은 컨텍스트)
|
|
Unsloth UD-Q4_K_XL (4bit)
|
약 25GB
|
RAM 32GB 이상
|
|
공식 int4 GGUF
|
약 26GB
|
RAM 32GB 이상
|
|
공식 int4 MLX + rec 엔진
|
-
|
Apple Silicon 통합메모리 48GB 이상
|
|
원본 BF16
|
약 80GB
|
데이터센터급 GPU
|
정리하면, 최소 24GB, 편하게 쓰려면 48GB 이상의 맥(Apple Silicon)이나 VRAM 넉넉한 NVIDIA GPU PC가 필요합니다. 컨텍스트를 길게 쓸수록 KV 캐시 때문에 메모리가 더 필요하다는 점도 기억해 두세요.
설치 방법 (초보자는 LM Studio 추천!)
1) LM Studio - 가장 쉬운 방법 LM Studio 모델 페이지에서 recursivesi/flint를 검색하고 'Use Model in LM Studio'를 누르면 끝입니다. 클릭 몇 번으로 GGUF 버전을 받아서 바로 채팅할 수 있습니다.
2) MLX (애플 실리콘 맥 전용)
uv tool install mlx-lm
mlx_lm.chat --model "RecursiveSI/flint-int4"
3) llama.cpp / Unsloth GGUF
pip install -U huggingface_hub
hf download unsloth/flint-GGUF flint-UD-Q4_K_XL.gguf --local-dir models/flint
4) Ollama
ollama run hf.co/unsloth/flint-GGUF:UD-Q4_K_XL
권장 샘플링 설정도 꼭 맞춰주세요. 성능 차이가 꽤 날 수 있습니다.
- Temperature: 1.0
- Top-p: 0.95
- Top-k: 20
혹시 장비가 부족하다면 OpenRouter에서 recursive/flint-v1.0을 무료로 써볼 수 있습니다. 다만 이건 클라우드에서 돌아가는 거라 '로컬'의 장점인 개인정보 보호는 사라집니다.
PC 사용자를 위한 안내 (노트북 아니어도 됩니다!)
"노트북에서 돌아간다"고 해서 노트북 전용은 아닙니다. 데이터센터 GPU 없이 개인 기기에서도 돌릴 만큼 가볍다는 뜻이고, 램이 충분한 Windows나 Linux 데스크톱 PC에서도 똑같이 돌아갑니다. 실제로 Recursive는 Nvidia RTX Spark에서 초당 150 토큰이 넘게 나왔다고 발표했습니다.
1) 맥과 PC는 메모리 구조가 다릅니다
맥은 CPU와 GPU가 같은 메모리를 함께 쓰는 '통합 메모리' 구조입니다. 반면 PC는 시스템 램과 그래픽카드 VRAM이 따로 나뉘어 있죠. 그래서 PC는 모델이 VRAM에 올라가느냐, 램에 올라가느냐에 따라 속도가 크게 달라집니다.
|
PC 구성
|
가능 여부
|
체감
|
|
VRAM 24GB 이상 그래픽카드 (RTX 3090/4090/5090 등)
|
매우 좋음
|
3~4bit 모델이 거의 다 VRAM에. 가장 빠름
|
|
램 32GB 이상 + 중급 그래픽카드 (VRAM 8~16GB)
|
좋음
|
GPU와 CPU에 나눠 올려서 실용적인 속도
|
|
램 32GB 이상, 그래픽카드 없음
|
가능
|
느리지만 채팅용으론 쓸 만함
|
|
램 24GB, 그래픽카드 없음
|
빠듯함
|
3bit 모델 + 짧은 컨텍스트로만
|
2) 그래픽카드가 없어도 될까?
보통 40B급 모델을 CPU로만 돌리면 초당 1~2토큰이라 답답해서 못 씁니다. 그런데 Flint는 토큰마다 2.5B만 계산하는 MoE 구조라 이야기가 다릅니다! 듀얼채널 DDR5 PC라면 대략 초당 10~25 토큰 정도는 기대해볼 만합니다. (램 속도와 CPU에 따라 다른 추정치입니다.) 사람이 읽는 속도보다는 빠르니 질문하고 답 받는 용도로는 충분하죠. 다만 긴 코드를 한꺼번에 넣으면 처음 읽어들이는 시간이 꽤 걸린다는 점은 감안하세요.
3) 중급 그래픽카드가 있다면 이 옵션을 꼭!
llama.cpp에는 MoE 모델의 '전문가' 레이어만 램으로 보내고, 나머지 핵심 레이어는 그래픽카드에 올리는 옵션이 있습니다.
llama-server -m flint-UD-Q4_K_XL.gguf -ngl 99 --n-cpu-moe 30 -c 32768
--n-cpu-moe 숫자를 VRAM이 넘치지 않을 만큼 조절해 주면 됩니다. 이렇게 하면 VRAM 8~12GB 그래픽카드로도 꽤 쾌적하게 쓸 수 있습니다. 명령어가 부담스럽다면 LM Studio의 'GPU 오프로드' 슬라이더로도 비슷하게 조절할 수 있습니다.
4) 램 용량별 추천 설정
|
시스템 램
|
추천 모델
|
컨텍스트
|
|
24GB
|
3bit (18.5GB)
|
8K 안팎
|
|
32GB
|
3bit 여유, 4bit 빠듯
|
16K~32K
|
|
48GB 이상
|
4bit 여유
|
32K 이상
|
24GB는 정말 최소선입니다. 모델 파일 18.5GB에 Windows 자체가 4~6GB를 쓰고, 대화 문맥을 기억하는 메모리(KV 캐시)까지 더해지니까요. 24GB PC라면 브라우저 같은 다른 프로그램은 최대한 닫고, 컨텍스트를 줄여서 쓰시는 게 좋습니다.
5) PC에서는 이 도구를 쓰세요
위 설치 방법 중 MLX는 애플 전용이라 PC에서는 안 됩니다. PC에서는 GGUF 파일을 쓰는 아래 도구 중 하나를 고르시면 됩니다.
- LM Studio : Windows에서 가장 쉬운 방법. 클릭 몇 번이면 끝!
- Ollama : 명령 한 줄로 실행. 에디터 플러그인 등과 연결하기 편함
- llama.cpp : 세밀하게 조절하고 싶을 때. 중급 그래픽카드 + MoE 조합에 가장 효율적
클라우드 AI vs 로컬 Flint 비교
|
항목
|
클라우드 (Claude, Codex 등)
|
로컬 Flint
|
|
비용
|
사용량만큼 과금
|
무료 (전기세 정도)
|
|
코드 보안
|
외부 서버로 전송
|
내 PC 밖으로 안 나감
|
|
오프라인
|
불가
|
가능
|
|
큰 작업 처리
|
강함
|
작게 나눠서 시켜야 함
|
|
응답 속도
|
네트워크 영향
|
빠름 (M4 Pro 기준 약 131 tok/s)
|
|
필요 장비
|
아무 PC나
|
24~48GB 메모리
|
|
설정 난이도
|
쉬움
|
약간 필요
|
Recursive도 스스로 인정한 부분인데, Flint는 대형 유료 코딩 어시스턴트보다 더 많은 안내가 필요하고, 큰 작업은 작은 단계로 나눠서 시키라고 권장합니다.
반면 Wired 기자가 48GB 맥에서 할 일 앱, 웹 리서치 도구 등을 만들어 봤는데, 작은 코딩 모델들이 보통 에러가 잦거나 느린 것과 달리 Flint는 요청을 매번 잘 처리했다고 합니다. 다른 실사용 리뷰들도 "범위가 정해진 작업에는 강하지만, 아주 큰 단일 파일 작업은 약하다"는 평가가 많았습니다.
초보 개발자 관점에서는?
1) 좋은 점
- 토큰 요금 걱정 없이 마음껏 물어보고 실험할 수 있습니다.
- 인터넷 없이도 돌아가니 카페나 비행기에서도 OK!
- Apache 2.0이라 개인 프로젝트, 상업 프로젝트 모두 자유롭게 쓸 수 있습니다.
2) 아쉬운 점
- 메모리 24GB 미만 노트북은 사실상 어렵습니다.
- 설치와 설정(양자화, 샘플링 값 등)에 약간의 공부가 필요합니다.
- 생성된 코드를 판단할 실력이 있어야 합니다. 이건 클라우드 AI도 마찬가지지만요.
추천 활용법 : 처음엔 LM Studio로 시작해서 함수 하나, 버그 하나 단위의 작은 작업부터 맡겨보세요. 설계나 큰 리팩터링은 클라우드 AI, 반복 작업이나 보안이 중요한 코드는 로컬 Flint로 나눠 쓰는 것이 가장 현실적인 방법인 것 같습니다.
마무리하며...
불과 1~2년 전만 해도 노트북에서 돌아가는 코딩 AI는 "장난감" 수준이었는데...
이제는 SWE-bench Verified 70%대 모델이 맥북에서 초당 100토큰 넘게 뱉어내는 시대가 되었습니다.
물론 아직 클라우드 최상위 모델을 완전히 대체하긴 어렵고, 벤치마크도 독립 검증이 더 필요한 상황입니다. 하지만 무료 + 오프라인 + 코드 보안 세 가지를 동시에 잡을 수 있다는 점만으로도 충분히 써볼 가치가 있다고 생각합니다.
메모리 넉넉한 맥이나 PC가 있다면 이번 주말에 한번 돌려보시는 건 어떨까요?
* 본 글의 벤치마크와 속도 수치는 Recursive 발표 및 언론 보도(TechCrunch 등) 기준이며, 실제 환경에 따라 다를 수 있습니다.
#RecursiveFlint #Flint #로컬AI #로컬LLM #코딩AI #AI코딩 #오픈소스AI #MoE #HuggingFace #LMStudio #Ollama #MLX #llamacpp #맥북AI #PC로컬AI #윈도우AI #SWEbench #개발자도구 #초보개발자 #AI개발
'AI & 개발' 카테고리의 다른 글
| 먼저 말 걸어오는 AI 비서, Claude Duet! 진짜 쓸 만한 에이전트가 나왔을까? (0) | 2026.11.05 |
|---|---|
| 텍스트 없이 '소리'만 듣고 말을 배운 AI, Block의 Dessa (0) | 2026.11.04 |
| Grok이 만든 AI 영화 《오디세이》 1화, 7분 보고 느낀 점 (1) | 2026.11.03 |
| OpenAI와 Anthropic은 왜 LLM 가격을 최대 80%나 내렸을까? (0) | 2026.10.30 |
| 헌책방에 갑자기 '큰손'이 나타났다? AI가 종이책을 사들이는 이유 (0) | 2026.10.26 |