


"어떤 모델이 1등이냐"보다 중요한 것 — 코딩·에이전트·광고·장시간 작업별 AI 선택 가이드
9월 첫째 주, 정말 정신없었습니다.
9월 1일 Anthropic이 Claude Fable 5.1과 Mythos 5.1을 내놓더니, 9월 2일에는 Google이 Gemini 3.8 Flash와 Gemini 3.8 Flash Cyber를, 같은 날 Meta가 Muse Spark 1.3을 발표했습니다. 그리고 9월 3일, OpenAI가 GPT-6 Astra까지 풀었죠. 나흘 만에 4개 회사가 신모델을 쏟아낸 겁니다.
CNBC는 이 현상에 아예 이름을 붙였습니다. 'model fatigue(모델 피로)'.
AI 클라우드 회사 Runpod의 CEO 젠 루(Zhen Lu)는 CNBC 인터뷰에서 "모델 피로는 실제로 존재한다"며 "시장이 너무 과열돼서, 다들 소음이라도 내야 하는 상황"이라고 말했습니다. 오픈AI 샘 알트먼 CEO도 "다들 더 빠른 주기로 움직이고 있다"고 인정했죠. 노트르담대 교수 아메드 아바시는 이걸 "share-of-wallet 게임"이라고 표현했는데, 2026년 한 해 2조 5,900억 달러 규모로 예상되는 AI 지출을 서로 뺏기 싫어서 벌어지는 일이라는 겁니다.
이런 상황에서 "그래서 어떤 모델이 제일 좋아요?"라는 질문은 사실 별 의미가 없습니다.
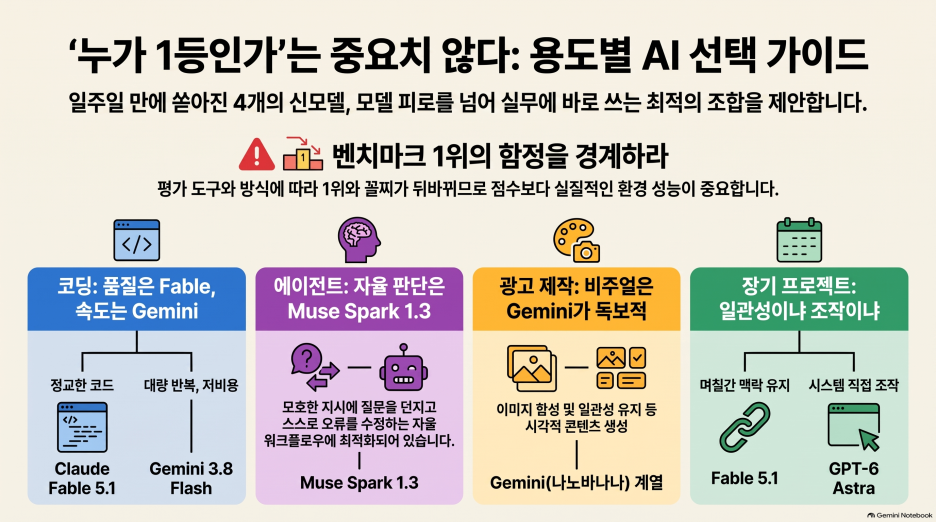
왜 "1등 찾기"가 함정인가
벤치마크 하나만 봐도 순위가 뒤집힙니다. 코딩 능력을 재는 DeepSWE v1.1 벤치마크에서는 Muse Spark 1.3이 75.4%로 1등, GPT-6 Astra가 74.1%, Gemini 3.8 Flash가 73.8%, Claude Fable 5.1이 67.4%로 꼴찌입니다.
그런데 실제 코딩 에이전트 환경에서 성능을 재는 Artificial Analysis의 Coding Agent Index를 보면 순서가 완전히 바뀝니다. Fable 5.1이 70.4로 1등, Astra가 67.0, Muse Spark 1.3(xhigh)이 64.2, Gemini 3.8 Flash가 61.1로 꼴찌입니다.
같은 4개 모델인데 어느 벤치마크를 보느냐에 따라 1등과 꼴찌가 뒤바뀌는 셈입니다. AI 뉴스레터 'The Weekly Kaitchup'은 이걸 두고 "네 회사가 발표한 숫자를 네 개의 점으로 늘어놓고 리더보드라고 부르지만, 실제로는 하나의 통제된 실험에서 나온 네 개의 관측치가 아니다"라고 지적했습니다. 도구 세트(harness)와 채점 방식이 회사마다 달라서, 벤치마크는 참고 자료일 뿐 정답은 아니라는 거죠.
그래서 "1등이 뭐냐"보다 "내 작업에는 뭐가 맞냐"로 질문을 바꾸는 게 훨씬 실용적입니다. 용도별로 정리해봤습니다.
코딩: 품질이냐, 속도/비용이냐
순수 코딩 작업이라면 독립 평가 기준으로는 Claude Fable 5.1이 Coding Agent Index에서 꾸준히 1위를 지키고 있습니다. 캐시 읽기 비용도 75% 인하돼서(100만 토큰당 $1→$0.25) 반복적으로 같은 코드베이스를 참조하는 작업에서 비용 부담이 크게 줄었습니다.
- GPT-6 Astra는 터미널 작업, 시스템 구성, 장문 컨텍스트 검색이 섞인 작업에서 강점을 보입니다. Terminal-Bench 4.0에서 Fable 5.1보다 소폭 앞섭니다.
- Muse Spark 1.3은 DeepSWE 같은 원시 코딩 벤치마크 점수는 높은 편이지만, 실제 에이전트 하니스 안에서는 상대적으로 낮게 나오는 경향이 있습니다. 대신 동급 지능 대비 작업당 비용이 가장 저렴한 편이라 "품질 대비 가격"을 우선한다면 고려할 만합니다.
- Gemini 3.8 Flash는 코딩 품질 자체보다 처리 속도와 토큰 단가(입력 $0.75, 출력 $3.75, 100만 토큰당)에서 압도적입니다. 대량의 반복 작업, CI 파이프라인처럼 속도가 곧 비용인 상황에 유리합니다.
정리: 코드 품질이 최우선이면 Fable 5.1, 터미널·시스템 작업 비중이 크면 Astra, 처리량과 단가가 중요하면 Gemini 3.8 Flash, 가성비를 극대화하고 싶다면 Muse Spark 1.3입니다.
에이전트 작업: 자율적으로 판단하고 도구를 써야 할 때
단순 질의응답이 아니라 여러 단계를 스스로 계획하고, 도구를 호출하고, 실패하면 수정해가며 목표를 완수해야 하는 작업이라면 기준이 달라집니다.
- Meta Muse Spark 1.3은 이번 출시에서 에이전트 워크플로우를 특히 강조했습니다. 여러 에이전트 하니스에 걸쳐 학습돼서 특정 환경에 종속되지 않고, 모호한 지시에는 먼저 확인 질문을 던지고, 막히면 사용자를 다시 끌어들이며, 중요한 액션 전에는 확인을 받도록 설계됐습니다. 이전 버전 대비 도구 호출은 20%, 토큰 소비는 25% 줄었다고 합니다.
- Claude Fable 5.1은 수 시간에서 수일에 걸친 작업에서도 계획을 유지하고, 실패 시 스스로 수정하며 작업을 이어가도록 설계됐다고 Anthropic이 밝혔습니다. 에이전트 작업에서는 캐시 절감 덕에 비용이 최대 45%까지 낮아진다는 점도 실무에서는 꽤 크게 작용합니다.
- Gemini 3.8 Flash도 "장시간 코딩과 자율 에이전트"를 위해 설계됐다고 Google이 강조했는데, 자체 출력을 재귀적으로 평가하고 개선하는 장기 실행 루프가 들어가 있습니다. 다만 이전 세대보다 "더 많이 생각하고 더 많은 도구를 호출"하는 방향이라 토큰 소비가 늘 수 있다는 점은 감안해야 합니다.
정리: 사람 개입을 최소화하고 장시간 스스로 돌아가야 하는 자율 에이전트라면 Muse Spark 1.3이나 Fable 5.1, 상대적으로 저렴하게 많은 에이전트 인스턴스를 굴려야 한다면 Gemini 3.8 Flash를 검토해볼 만합니다.
광고/콘텐츠 제작: 텍스트가 아니라 이미지·영상이 필요할 때
이번에 나온 네 모델 중 순수 텍스트 카피 작성이라면 위 코딩·에이전트 기준을 그대로 적용해도 되지만, 이미지나 영상이 필요한 광고 소재 제작이라면 이야기가 다릅니다.
이 영역에서는 **Gemini 계열(나노바나나, Nano Banana)**이 사실상 독보적입니다. Gemini 3.1 Flash Image(나노바나나 2)와 Gemini 3 Pro Image(나노바나나 Pro)는 로고를 실제 제품 사진에 자연스럽게 합성하거나, 여러 참조 이미지를 기반으로 인물·제품의 일관성을 유지한 채 다양한 장면·카메라 앵글로 변형하는 데 강점이 있습니다. 4K 출력과 실시간 웹 검색 기반의 정확한 정보 반영도 지원해서, Adobe Firefly나 Figma 같은 디자인 툴에도 파트너 모델로 이미 통합돼 있습니다.
반대로 Claude(Fable 5.1)는 네이티브 이미지 생성 기능이 없고, 카피라이팅·기획안·소재 브리프 작성 같은 텍스트 기반 업무에 쓰는 게 맞습니다. GPT-6 Astra와 Muse Spark 1.3도 멀티모달 입력(이미지·영상 이해)은 지원하지만, 광고 이미지를 "새로 그려내는" 생성 품질 면에서는 나노바나나 계열이 한발 앞서 있다는 평가가 많습니다.
정리: 이미지·영상 소재 제작 자체는 Gemini(나노바나나) 계열, 카피·기획·시나리오 같은 텍스트 작업은 Fable 5.1이나 Astra처럼 코딩·추론에 강한 모델과 나눠 쓰는 조합이 현실적입니다.
장시간 작업: 몇 시간, 며칠씩 이어지는 프로젝트
에이전트 작업과 겹치는 부분도 있지만, 여기서는 "혼자 알아서 판단"하는 자율성보다 긴 시간 동안 맥락을 놓치지 않고 버티는 능력에 초점을 맞춰보겠습니다.
- Claude Fable 5.1은 Anthropic이 "수 시간에서 수일에 걸친 작업에서도 계획을 유지"하도록 설계했다고 명시한 만큼, 장기 프로젝트에서의 일관성을 강점으로 내세우고 있습니다.
- GPT-6 Astra는 컨텍스트 윈도우가 105만 토큰으로 넉넉하고, 컴퓨터·브라우저를 직접 조작하며 장시간 업무를 처리하는 데 초점을 맞췄습니다. Codex와 조합하면 작업 완료 속도가 기존 대비 1.9배 빨라졌다고 OpenAI는 밝혔습니다.
- Muse Spark 1.3도 컨텍스트 윈도우가 약 104만 토큰 수준이며, 장기 실행 스레드 안에 여러 워크플로우를 담아두고 진행 상황을 스스로 점검하도록 설계됐습니다. 사용자가 원하면 자주 상태 보고를, 원치 않으면 조용히 백그라운드 실행을 하도록 조정할 수 있는 점도 특징입니다.
정리: 며칠씩 이어지는 프로젝트에서 일관성이 중요하면 Fable 5.1, 컴퓨터·브라우저 조작이 섞인 장시간 업무라면 Astra, 진행 상황 보고 방식을 세밀하게 조정하고 싶다면 Muse Spark 1.3을 우선 검토해보시길 권합니다.
그 외: 일상적인 질문, 빠른 답변이 필요할 때
매번 복잡한 벤치마크를 따져가며 쓸 필요가 없는 경우도 많습니다. 간단한 질문, 요약, 아이디어 스케치처럼 부담 없는 작업이라면 속도와 비용이 가장 중요한 기준이 됩니다.
이럴 때는 Gemini 3.8 Flash가 가장 무난합니다. 토큰 단가가 낮고 응답이 빠르며, 텍스트·이미지·오디오·영상을 한 번에 처리할 수 있는 멀티모달 입력도 지원합니다. 굳이 최고 성능 모델을 켜서 비용을 태울 필요가 없는 업무에는 이쪽이 합리적입니다.
참고로 사이버 보안 취약점 탐지·패치처럼 고도로 민감한 방어 업무는 Anthropic의 Mythos 5.1, Google의 Gemini 3.8 Flash Cyber, OpenAI의 데이브레이크(Daybreak) 프로그램처럼 별도 신뢰 접근 프로그램을 통해서만 열려 있는 특수 모델들이 있습니다. 일반 사용자가 접근할 일은 거의 없지만, 이런 모델이 별도로 존재한다는 것 자체가 요즘 프론티어 모델들의 사이버 보안 능력이 그만큼 민감해졌다는 신호이기도 합니다.
마무리하며
한 스타트업 CEO가 CNBC 인터뷰에서 한 말이 꽤 인상적이었습니다. 매번 나오는 모델을 전부 평가하려 들지 말고, 후보를 다섯 개 정도로 못 박고 그 안에서만 고르라는 조언이었습니다. AI 컨설팅 업체 Farsight의 CTO 노아 파로는 이번 9월 발표들 대부분을 "포인트 릴리스"라고 불렀고, 진짜 판을 바꾼 릴리스는 6월의 Fable 5와 7월의 Kimi K3였다고 짚었습니다.
결국 매주 바뀌는 리더보드 1등을 쫓아다니기보다, 내가 자주 하는 작업이 코딩인지 에이전트인지 광고 소재 제작인지 장시간 프로젝트인지를 먼저 정의하고, 거기에 맞는 모델 한두 개를 정해서 익숙해지는 편이 실무에서는 훨씬 남는 장사입니다. 모델은 계속 나올 거고, 그 사이클은 앞으로도 안 멈출 테니까요.
#모델피로 #ClaudeFable5.1 #GPT6Astra #Gemini3.8Flash #MuseSpark1.3 #AI모델선택 #코딩AI #에이전트AI #나노바나나 #프롬프트엔지니어링
'AI & 개발' 카테고리의 다른 글
| 이제 좀 천천히 갑시다 - 빅테크 4대장이 던진 'AI 속도조절론' (0) | 2026.09.15 |
|---|---|
| 이세돌 이후 9년 만에... 신진서, AI 바둑엔진 '카타고'를 꺾다 (0) | 2026.09.14 |
| OpenClaw 2.0, 얼떨결에 완성되다 (0) | 2026.09.13 |
| Claude Code 컨텍스트 관리, 이것만 알아도 토큰 절반 줄인다 (0) | 2026.09.12 |
| OpenAI, 차세대 모델 'GPT-6 Astra' 공개, 사용자들의 반응은? (0) | 2026.09.09 |